أسعار العملات
دولار أمريكي3.02
يورو3.37
جنيه مصري0.05
دينار أردني4.27
جنيه إسترليني4.03
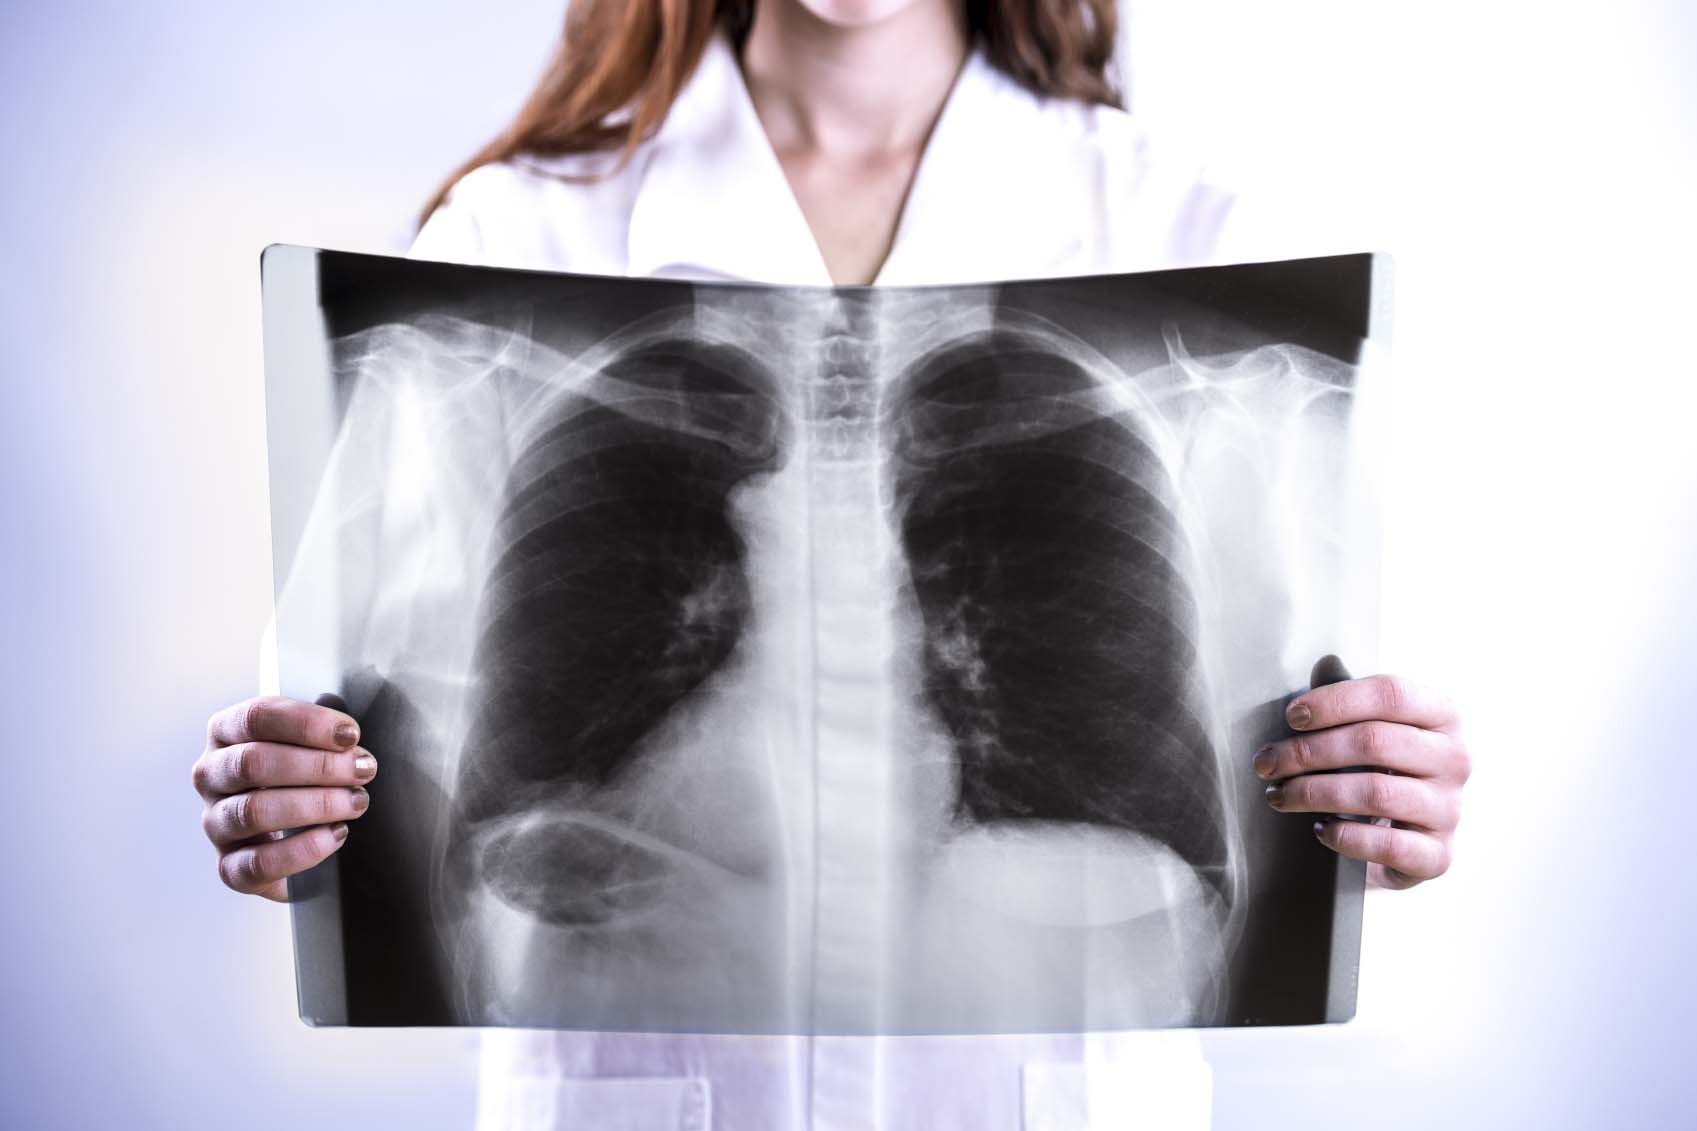
كشفت دراسة علمية حديثة أن نموذج الذكاء الاصطناعي "تشات جي بي تي - 5"، التابع لشركة "أوبن إيه آي"، أخفق في اكتشاف نحو نصف كسور المعصم التي عُرضت عليه خلال اختبار لصور الأشعة السينية، ما يثير تساؤلات بشأن موثوقية استخدام النماذج العامة للذكاء الاصطناعي في التشخيص الطبي دون إشراف متخصص.
وأظهرت النتائج أن النموذج لم يتمكن من تحديد 83 كسرًا من أصل 170 كسرًا مثبتًا في الصور المشمولة بالتحليل، إذ بلغت حساسيته في اكتشاف الكسور 51.2%، فيما سجل دقة إجمالية قدرها 61.6%.
ونُشرت الدراسة في مجلة "إيمرجنسي راديولوجي" العلمية خلال أكتوبر/ تشرين الأول 2026، وتناولت أداء النموذج في اكتشاف كسور الطرف البعيد من عظم الكعبرة، القريب من مفصل المعصم، باستخدام صور أشعة مأخوذة من قاعدة بيانات طبية متاحة للباحثين.
واختبر الباحثون 396 صورة أشعة أمامية مأخوذة من قاعدة بيانات "مورا"، التي طورتها جامعة "ستانفورد"، وعرضوا كل صورة على النموذج في محادثة مستقلة.
وطُلب من النموذج تحديد ما إذا كانت الصورة تحتوي على كسر، عبر سؤال واحد يتطلب الإجابة بنعم أو لا، دون تزويده بمعلومات عن التاريخ المرضي أو الأعراض السريرية، ودون تقديم أمثلة تدريبية أو تعليمات إضافية.
واستبعد الباحثون 26 صورة من التحليل الرئيسي بعدما قدم النموذج إجابات غير حاسمة، ليقتصر التقييم النهائي على 370 صورة، منها 170 صورة تحتوي على كسور و200 صورة خالية منها.
وأظهرت النتائج أن حساسية النموذج، أي قدرته على اكتشاف الكسور الموجودة فعلًا، بلغت 51.2%، بينما وصلت النوعية، التي تقيس قدرته على تمييز الصور الخالية من الكسور، إلى 70.5%.
أما الدقة الإجمالية، التي تعكس نسبة التصنيفات الصحيحة بين جميع الصور المشمولة بالتحليل، فبلغت 61.6%.
وسجل النموذج كذلك 59 نتيجة إيجابية خاطئة، إذ أشار إلى وجود كسور في صور لا تحتوي عليها، مقابل 83 نتيجة سلبية خاطئة، لم يتعرف فيها على كسور موجودة بالفعل.
واعتمد الباحثون في تحديد النتائج الصحيحة على تصنيف اتفق عليه طبيبان متخصصان في جراحة العظام، بدلًا من الاكتفاء بالتصنيفات الأصلية لقاعدة البيانات.
وأوضح الباحثون أن النتائج تتعلق بإصدار محدد من النموذج وطريقة اختبار واحدة ومنطقة تشريحية بعينها، ولا يمكن تعميمها على جميع نماذج الذكاء الاصطناعي أو الأنظمة المتخصصة في تحليل الصور الطبية.
كما أن الدراسة استعادية، اعتمدت على صور موجودة مسبقًا، ولم تختبر أداء النموذج ضمن مسار تشخيص سريري متكامل يشمل الفحص الطبي والأعراض وصور الأشعة من زوايا متعددة.
وتعود الصور المستخدمة إلى قاعدة بيانات "مورا"، التي تضم 40,561 صورة أشعة متعددة الزوايا، مأخوذة من 14,863 فحصًا طبيًا شملت 12,173 مريضًا.
وتغطي القاعدة سبع مناطق من الأطراف العلوية، هي المرفق والأصابع والساعد واليد والعضد والكتف والمعصم، وقد صنف اختصاصيو الأشعة في مستشفى "ستانفورد" فحوصها الأصلية إلى طبيعية وغير طبيعية خلال الفترة بين عامي 2001 و2012.
وصُممت القاعدة لدعم الأبحاث المتعلقة بتطوير خوارزميات قادرة على اكتشاف الحالات غير الطبيعية في صور الأشعة، وهي مهمة أوسع من تحديد وجود كسر محدد.
وتتيح البنية البحثية الأصلية استخدام أكثر من صورة للفحص الواحد، مع دمج احتمالات وجود حالات غير طبيعية عبر الزوايا المختلفة، فيما تستخدم المسابقة المرتبطة بالمشروع مجموعة اختبار غير معلنة لتقييم أداء النماذج البحثية.
لكن استخدام هذه البيانات لا يعني أن أي نموذج يُختبر عليها يصبح مؤهلًا تلقائيًا للاستخدام الطبي، إذ تتطلب التطبيقات السريرية تقييمات مستقلة تثبت دقتها وموثوقيتها في ظروف الاستخدام الفعلية.
وفي هذا السياق، حذرت "منظمة الصحة العالمية"، في إرشادات أصدرتها عام 2024 بشأن نماذج الذكاء الاصطناعي متعددة الوسائط، من مخاطر الاعتماد غير المدروس على هذه التقنيات في الرعاية الصحية.
وأشارت المنظمة إلى ما يُعرف باسم "الانحياز للأتمتة"، وهو ميل المستخدمين، بمن فيهم الأطباء والمرضى، إلى الثقة بنتائج الأنظمة الآلية بصورة قد تدفعهم إلى تجاهل أخطاء كان يمكن اكتشافها بوسائل أخرى.
كما نبهت إلى احتمال إنتاج النماذج معلومات غير دقيقة أو ناقصة أو متحيزة، وإلى تأثير جودة بيانات التدريب وطبيعة الاستخدام في موثوقية النتائج.
وتوضح إرشادات المنظمة أن تطبيقات الذكاء الاصطناعي في المجال الصحي تشمل المساعدة السريرية والإجابة عن استفسارات المرضى وتلخيص السجلات الطبية والتعليم والبحث العلمي، لكن نجاح النموذج في مهمة معينة لا يثبت بالضرورة صلاحيته لتنفيذ مهام أخرى.
ودعت المنظمة إلى تطوير الأنظمة الطبية لأغراض محددة، مع إخضاعها لاختبارات تقيس مستويات الدقة والموثوقية المطلوبة، بدلًا من الاعتماد على قدرتها على توليد إجابات تبدو مقنعة.
وشددت كذلك على أهمية إشراك الأطباء والمرضى والجهات التنظيمية في تصميم هذه الأدوات وتقييمها، وإجراء تدقيق مستقل لأدائها بعد نشرها على نطاق واسع، مع مراعاة حماية بيانات المرضى ورصد الاختلافات في النتائج بين فئات المستخدمين.
وتشير نتائج الدراسة إلى أن استخدام نموذج عام للذكاء الاصطناعي لتفسير صور الأشعة اعتمادًا على سؤال مختصر لا يوفر مستوى موثوقًا من اكتشاف الكسور في ظروف الاختبار، فيما يبقى تقييم إمكانات النماذج الطبية المتخصصة مرهونًا بدراسات مستقلة واختبارات سريرية ملائمة.